GPT-6 Astraは何回使える? Solとの料金差を追加実測、Plus・Proの目安も更新
GPT-6 Astraが使えるようになったため、Solと同じ4課題を各3回実行。トークン数・換算費用・時間を比較し、キャッシュの影響、Plus・Proの公式回数目安、Fast modeの料金を整理しました。
目次
GPT-6 Astraが使えるようになったため、Solと同じ4課題を各3回実行。トークン数・換算費用・時間を比較し、キャッシュの影響、Plus・Proの公式回数目安、Fast modeの料金を整理しました。
2026年9月6日、手元のCodex CLIでGPT-6 Astraの応答を確認できました。初稿ではSolの実測にAstraの単価を当てていましたが、今回は両モデルへ同じ4種類の依頼を各3回ずつ送り、トークン数と応答までの時間を測りました。公式にもAstraの利用回数の目安が追加されています。
- •Astraの公式目安はPlusで5時間あたり5〜45回。保証された回数ではありません
- •単価が2.5倍でも、1作業の消費が2.5倍とは限りません。入力・出力・キャッシュの量が変わります
- •今回のAstra実測と、9月4日のSolだけの実験は分けて掲載。換算クレジットは残量の実測ではありません
AstraとSol、単価の差と能力の差は分けて考える
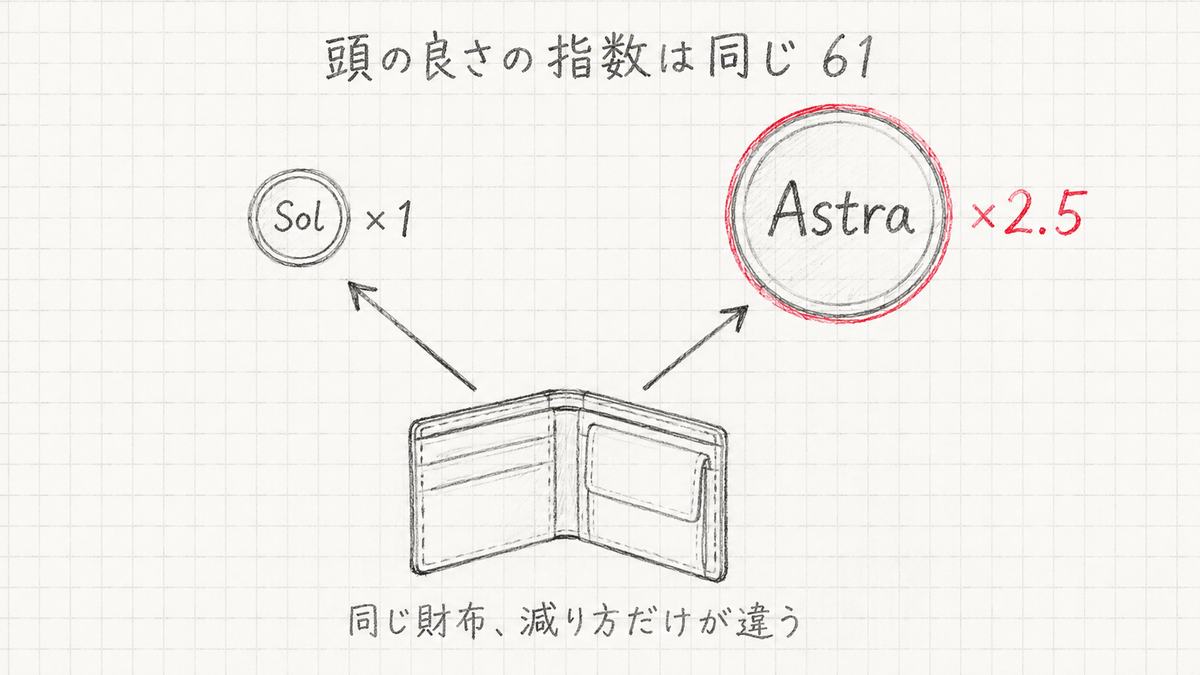
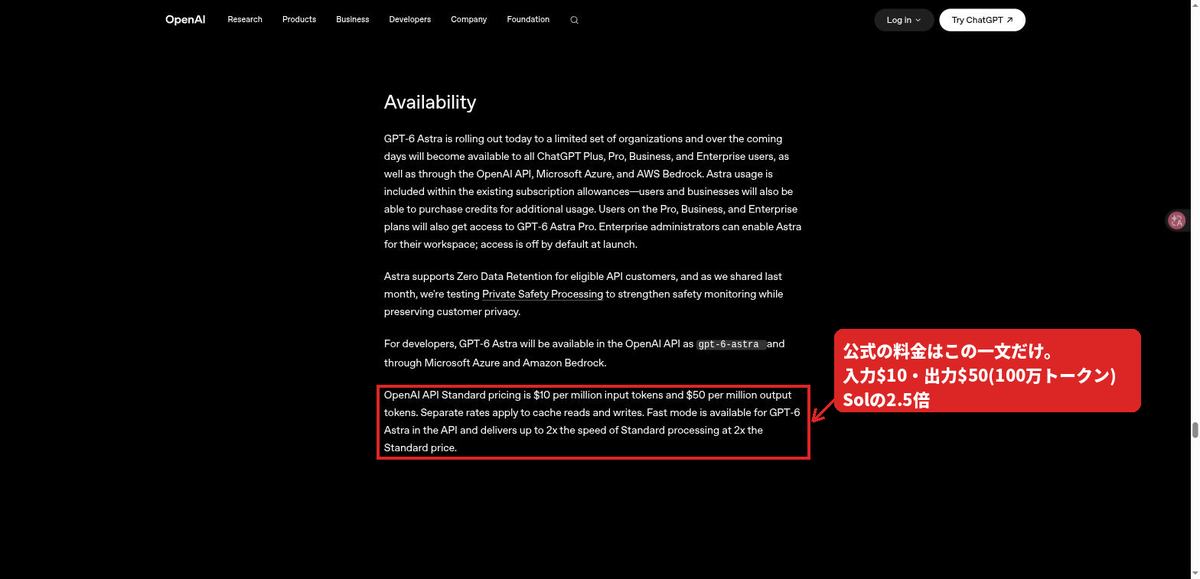
標準API料金は、100万トークンあたりAstraが入力10ドル・出力50ドル、Solが入力4ドル・出力20ドルです。同じ量なら2.5倍ですが、必要な量まで同じとは限りません。初稿の「頭の良さは同じ」は、一つの評価指標から広く言い切りすぎたため訂正します。今回の短い課題だけでも、能力全般の優劣は判定できません。Astraの公式仕様、Solの公式仕様。
GPT-6 Astraとは。何が変わったのか
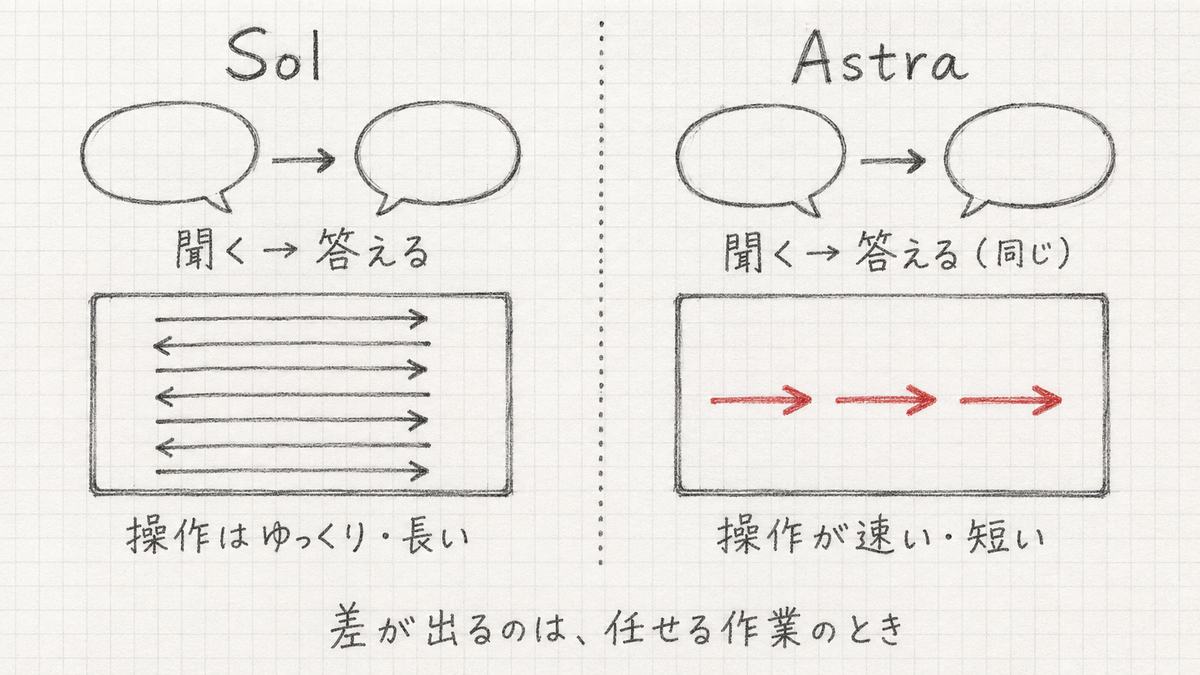
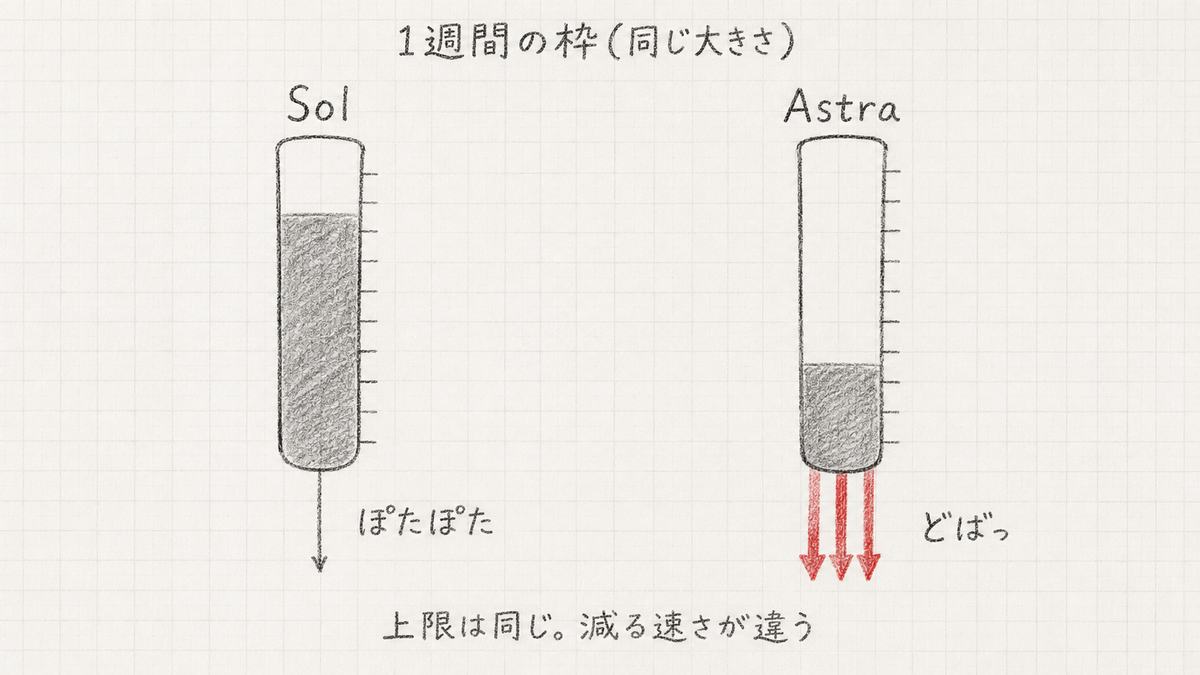
OpenAIはAstraを、コード・ブラウザ・業務ソフトをまたぐ複数段階の作業に強いモデルと説明しています。上の図は初稿で作った説明用の模式図であり、筆者がAstraとSolの画面操作を比較測定した結果ではありません。公式が挙げる特徴は次のとおりです。
- •画面操作やソフトウェア開発を含む、複数段階の作業を進める能力
- •作業中に追加された指示への対応。終わった作業を引き継ぎながら方向を変える機能
- •一部の評価で出力トークンが減ったこと。すべての依頼で短くなるという保証ではありません
出典は公式モデルガイドです。今回の追加検証では画面操作の速さや長時間の開発、安全確認による拒否率は測っていません。
料金。標準単価は2.5倍、Fast modeは別計算
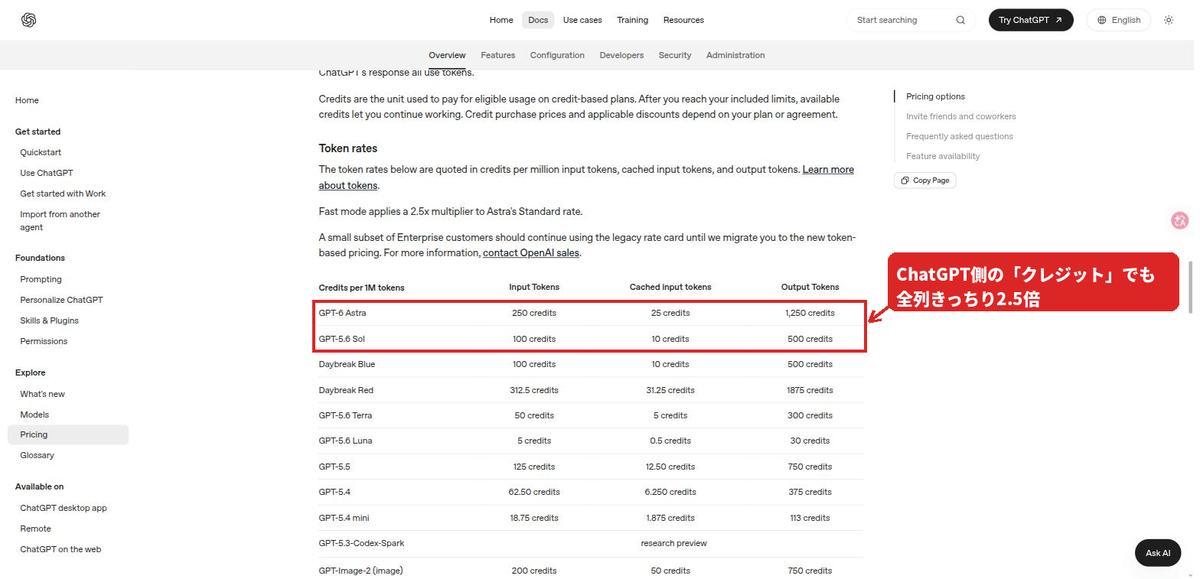
WorkとCodexの公式クレジット表では、100万トークンあたりAstraが入力250・キャッシュ済み入力25・出力1,250クレジット。Solは100・10・500です。この単価でログを換算できますが、プランの残量表示や実際の請求を測ったことにはなりません。公式料金表(2026年9月6日確認)。
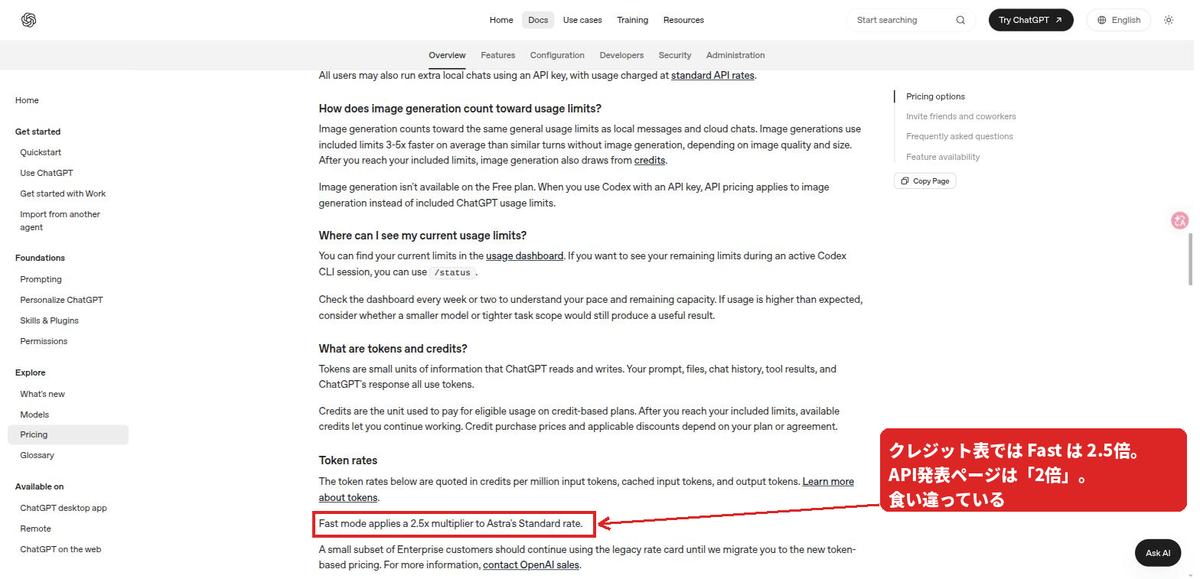
AstraのFast modeは、ChatGPTのクレジットでは標準の2.5倍、APIの公式仕様では適用単価の2倍です。課金経路が違うため、初稿のように「食い違い」とは扱いません。CLIでは /fast status で状態を確認できます。公式の速度設定。
Solの割引価格は「少なくとも2026年11月21日まで」と案内されています。その翌日に必ず値上げされる、とは読めません。価格を比較するときは確認日もそろえる必要があります。
何回使える? Plusは5時間あたり5〜45回が公式目安
2026年9月6日確認の公式表には、Astraのローカルメッセージの目安が載っています。Plusは5〜45回、Pro 5xは25〜225回、Pro 20xは100〜900回で、いずれも5時間あたりです。作業の重さで変わる目安で、固定の通数制限ではありません。週の上限が適用される場合もあります。
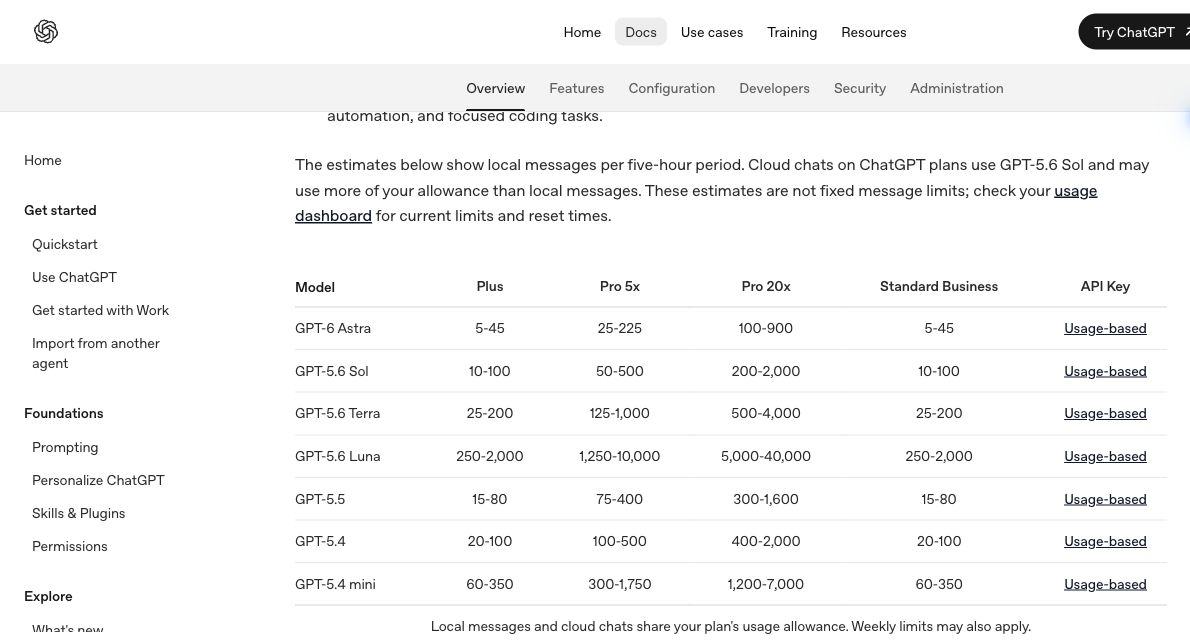
以下は初稿で掲載した9月4日の画面です。新しい回数目安は上の表を参照してください。
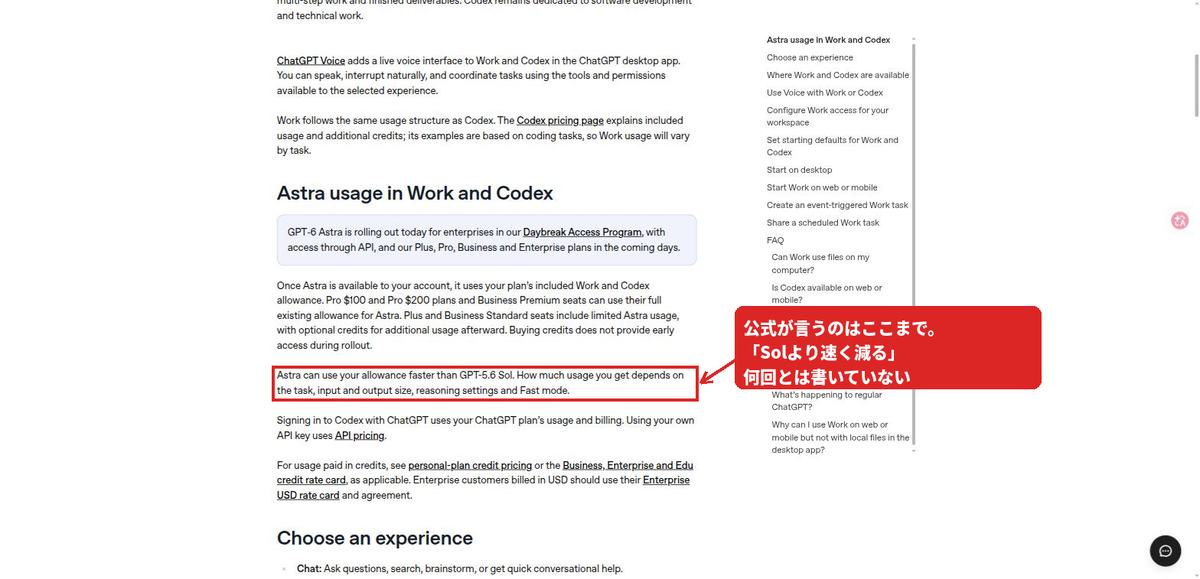
初稿の「公式は数字を出していない」と、Solの目安を2.5で割った「4〜40回」は撤回し、公式が出したAstraの目安へ更新しました。下のメーター図も、同じ量を処理する場合の単価差を表す模式図です。実際の残量変化ではありません。
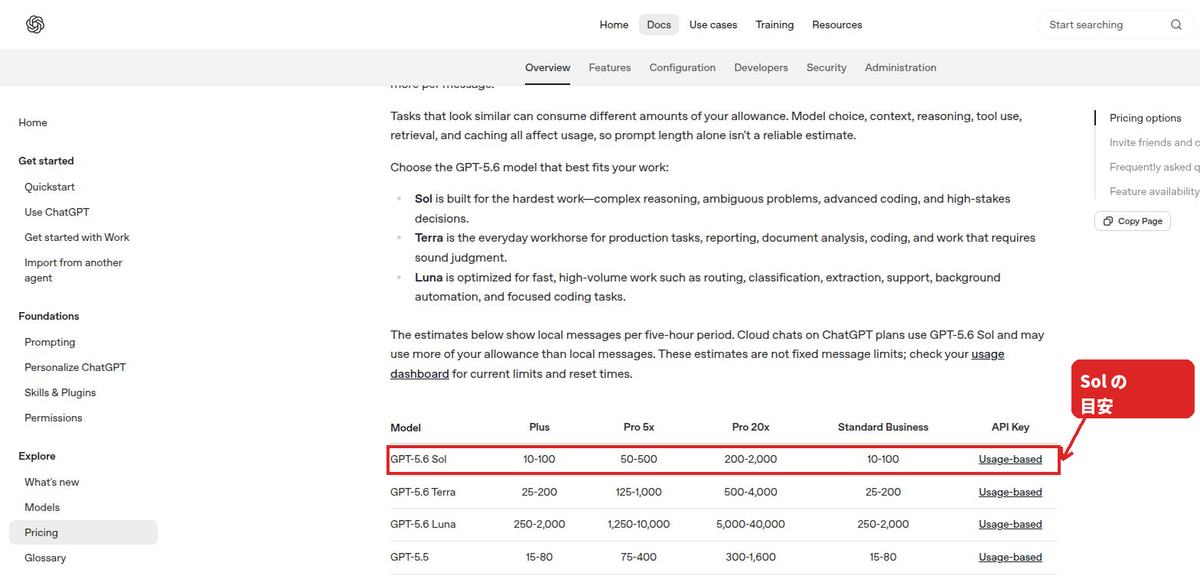
残量とリセット時刻は、自分のアカウントの利用状況画面かCodexの /status で確認します。この記事では上限に達するまで連続実行する検証はしていません。
9月6日の追加実測:同じ4課題をSolとAstraへ各3回
Codex CLI 0.153.4、ChatGPTログイン、考える深さmediumで実行しました。各回を新しい会話にし、課題ごとにモデルを交互に実行。2巡目は実行順を反転しています。設定ファイルは読み込まず、Fast modeの指定もしていません。ただし、共通のAGENTS.md、スキル一覧、モデル固有の基本指示はログに残っており、何もない状態のAPI比較ではありません。
課題は、40文字以内の労い、取込結果の100文字要約、返品を含む売上計算、0分と未終了を扱う平均計算コードの不具合指摘です。いずれもツールを使わず答えるよう指定し、24回すべてでツール実行がないことを確認しました。入力は約2.1万〜2.2万トークン。短い依頼でも、質問以外の指示が多く含まれています。
| 課題 | Sol | Astra | 平均の比率 |
|---|---|---|---|
| 短い労い | 1.11(1.10〜1.12) | 2.04(0.62〜2.76) | 1.84倍 |
| 要約 | 1.14(1.14〜1.14) | 2.83(2.83〜2.84) | 2.48倍 |
| 売上計算 | 1.00(0.77〜1.13) | 2.80(2.78〜2.81) | 2.80倍 |
| コードの不具合指摘 | 0.90(0.31〜1.19) | 2.88(2.88〜2.89) | 3.22倍 |
この比率を「Astraは実務で1.84〜3.22倍高い」と一般化することはできません。たとえばAstraの労いは、キャッシュ済み入力が12,160から21,632トークンへ増えた回に、換算値が約2.75から約0.62へ下がりました。Solのコード指摘でもキャッシュが増えています。平均には、モデルの違いだけでなく、その時点のキャッシュの違いが混ざっています。
計算式は、通常入力×入力単価+キャッシュ済み入力×キャッシュ単価+出力×出力単価です。ログのinput_tokensからcached_input_tokensを引いて通常入力とし、100万で割ります。output_tokensには内部の推論分も含まれるため、reasoning_output_tokensは二重に足していません。今回のcache_write_input_tokensは全件0でした。表は標準単価での換算であり、アカウント残量の減少や購入クレジットの引き落としを直接測ったものではありません。
Astraの出力は短くなった? 返答は速かった?
| 課題 | 出力 Sol → Astra | 所要時間 Sol → Astra |
|---|---|---|
| 短い労い | 31.3 → 25.0 | 5.72秒 → 6.75秒 |
| 要約 | 84.7 → 72.7 | 6.58秒 → 8.09秒 |
| 売上計算 | 47.7 → 50.0 | 5.59秒 → 6.94秒 |
| コードの不具合指摘 | 171.0 → 115.7 | 8.51秒 → 9.46秒 |
4課題中3課題ではAstraの出力トークンが少なくなりました。ただし、見える文章が必ず短くなったわけではありません。コード指摘ではSolの内部推論が平均72トークン、Astraは0で、その差も含みます。時間はコマンド起動から終了までの実測で、起動処理や通信を含みます。この条件ではAstraの平均時間は4課題とも長く、画面操作や長い開発作業の速度差を示す結果ではありません。
安く返っても、答えが違えば比較にならない
売上計算は両モデルとも3回すべて、A店5,200円、B店4,500円、全店9,700円という正しいJSONを返しました。コード指摘は全6回で、0を除外する条件と対象なしのゼロ除算を指摘し、Noneだけを除いて空ならNoneを返す修正版を提示しました。短い労いも全6回が40文字以内でした。
要約は、両モデルとも失敗した3件だけを再取込し、機能追加は未決定と伝えました。ただしSolは3回中2回、すでに起きた「117件成功」も「決定:」の下へ置いていました。Astraは3回とも取込結果と決定・未決定を分けています。これは小さな表現差の観測で、モデル全体の能力順位を決めるほどの検証ではありません。
使ったプロンプトと実行条件
同じ端末・ログイン・CLIで、各課題を3回ずつ実行しました。下のコマンドのモデル名だけを切り替え、1回ごとに新しい会話を開始しています。標準出力のturn.completedにあるusageを集計し、正常終了を確認しました。
codex exec --ignore-user-config --skip-git-repo-check -C <検証用フォルダ> -s read-only -m gpt-6-astra -c 'model_reasoning_effort="medium"' --json '<下記のプロンプト>'
# 比較時は -m gpt-5.6-sol
短文:ツールを使わず答えてください。仕事を終えた同僚へ、労いの一言を日本語40文字以内で書いてください。
要約:ツールを使わず、次の記録だけを根拠に100文字以内で要約してください。決定と未決定を区別してください。記録:9時にCSV取込を開始。120件中117件が成功、3件が郵便番号の桁数不正で失敗。担当者は元データ修正後に3件だけ再取込することを決めた。画面の改善案としてエラー行ダウンロードが出たが実装は未決定。成功済み117件は再取込しない。
計算:ツールを使わず計算してください。売上明細は税込で、A店は1200円が3件と800円が2件、B店は1500円が2件と500円が4件。B店の500円を1件返品。返品後の店舗別合計と全店合計をJSONだけで返してください。キーはA、B、total。
ツールを使わず、次のPython関数の不具合を説明し、修正版と境界例を各1つ示してください。要件:終了した作業の平均時間を返す。0分の作業も含める。未終了はNoneなので除く。対象がなければNoneを返す。
def average_minutes(values):
    done = [v for v in values if v]
    return sum(done) / len(done)
回答は日本語300文字以内。
キャッシュは消去・固定していません。モデル固有の基本指示も異なるため、入力トークン数は一致しません。同じプロンプトを渡したCodex利用時の観測として掲載しています。
9月4日の検証:Solで7種類の作業を測った
ここからは9月4日の初稿に載せた実験です。個人のChatGPT ProにログインしたCodex CLI(0.153.2)で、7種類の作業を各1回実行し、ログのトークン数を料金表で換算しました。当日はAstraを利用できず、画像のAstra列はSolの数値を2.5倍した仮定です。今回の追加実測と混ぜて比較しないでください。
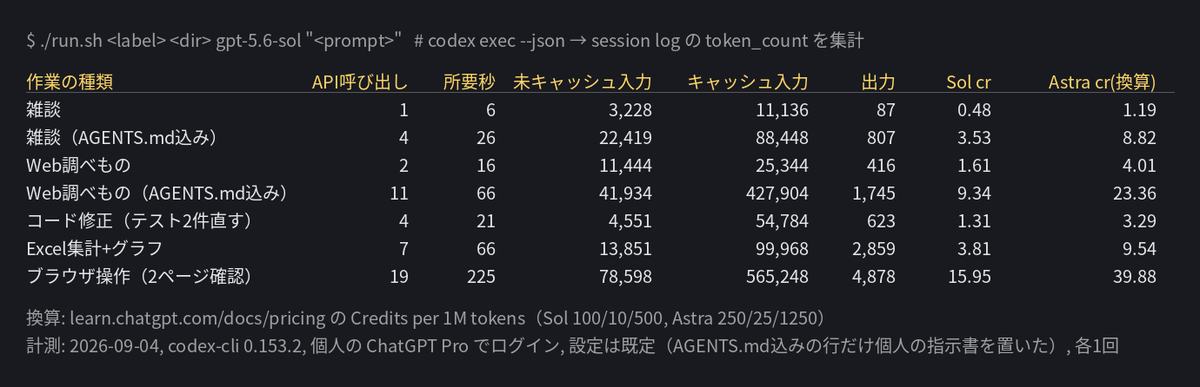
雑談1回が0.5クレジット。Web検索つきの調べものが1.6、テストを2件直すコード修正が1.3、Excelの集計表とグラフを作らせて3.8、ブラウザを実際に操作させて2ページ確認すると16。雑談を1とすると、ブラウザ操作は33倍です。
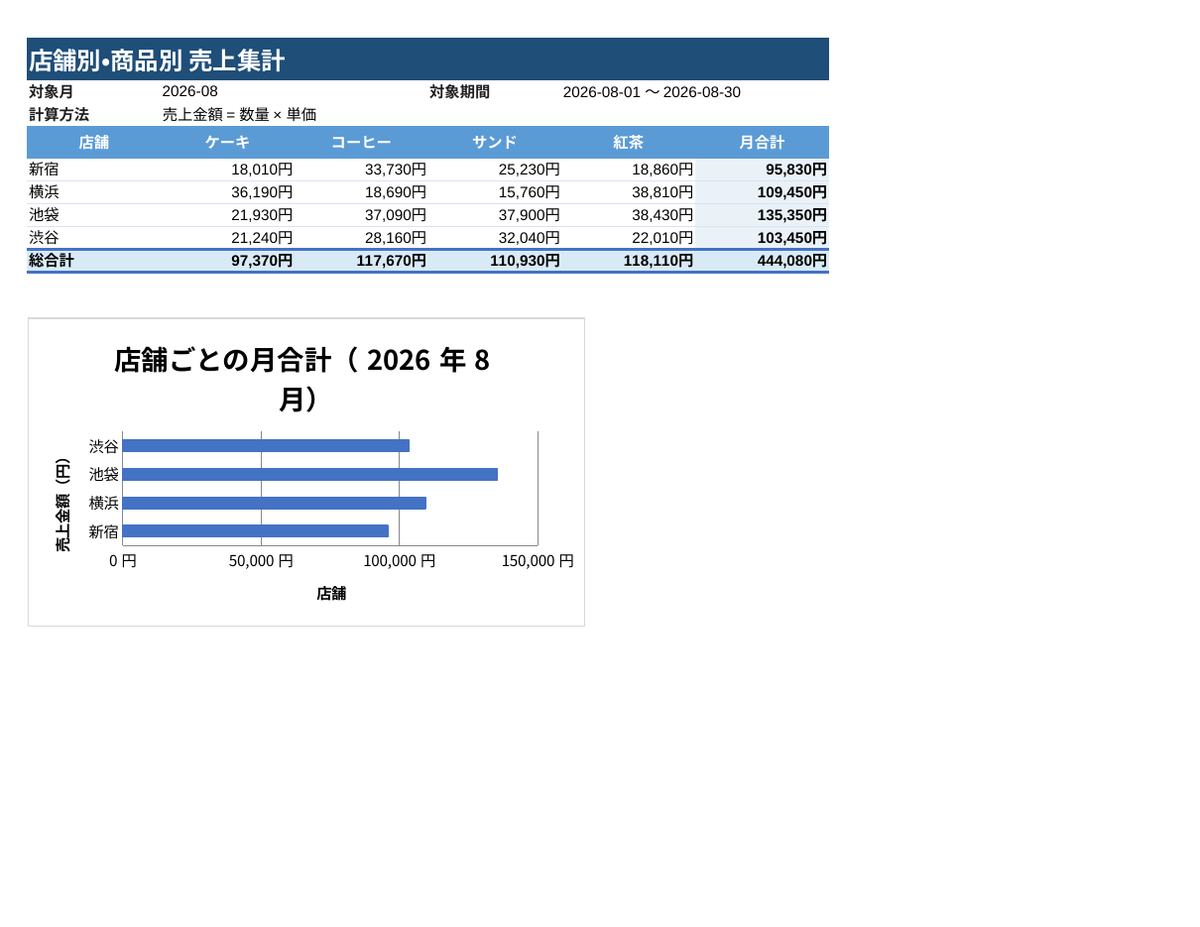
たとえばこのExcelの集計表。売上の明細180行から店舗別・商品別の表とグラフを作らせて、3.8クレジット。Astraなら換算で9.5です。
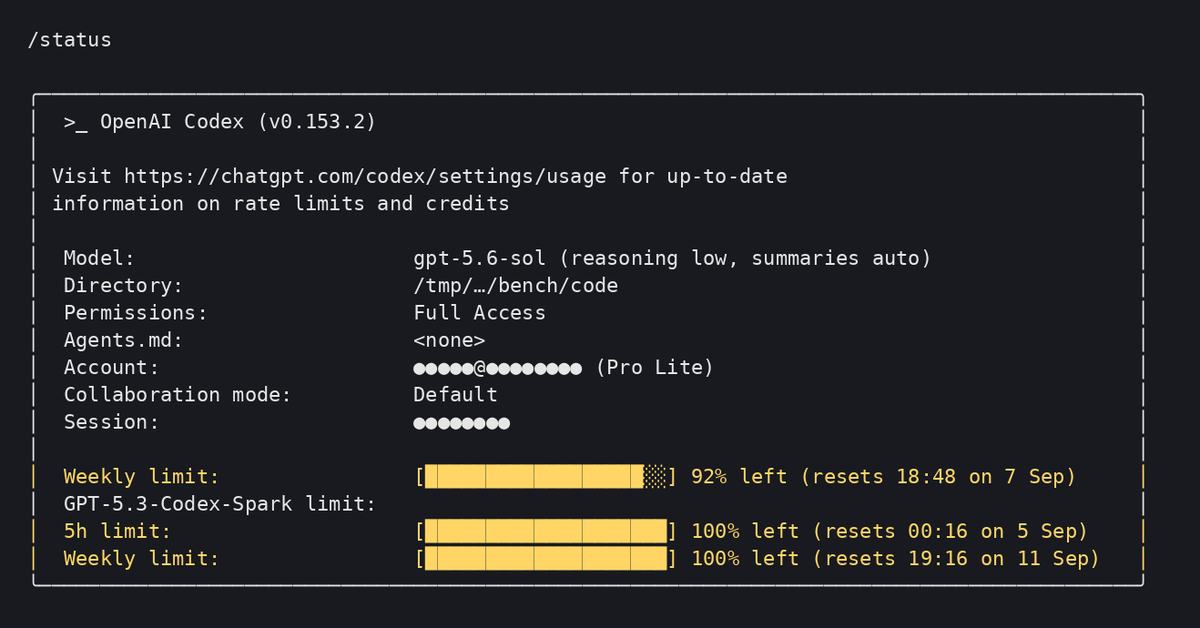
当日の /status では、筆者のアカウントに週の残量が表示されていました。この一画面から、ほかの時間枠が存在しない、あるいは全アカウントが同じ制限で動くとは判断できません。
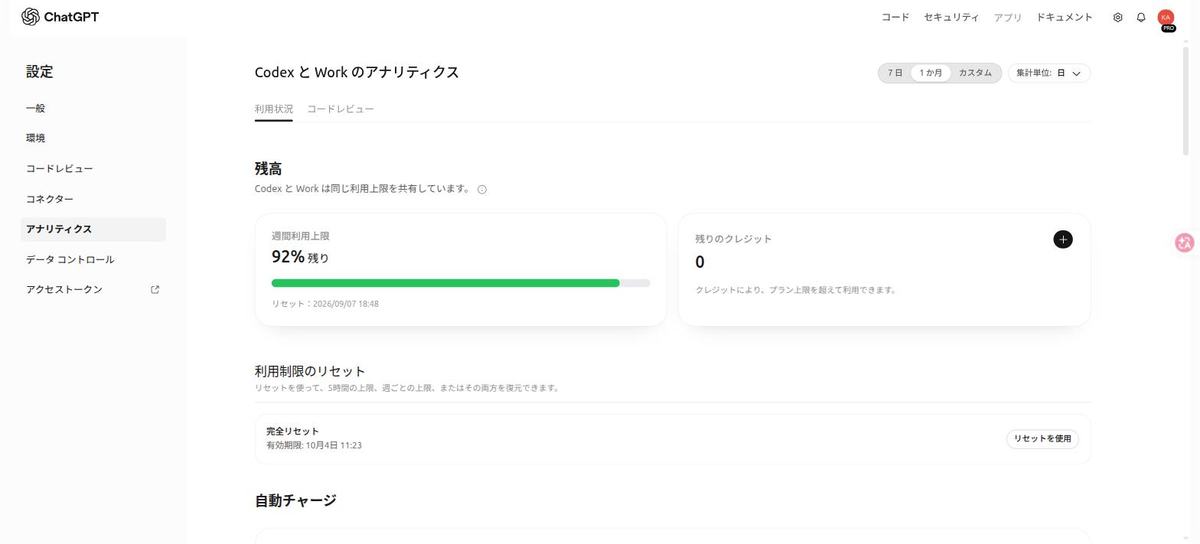
ブラウザからは、ChatGPTの設定にある「アナリティクス」で同じ残量が見えます。7本を回しても、週の枠は8%使用のまま動きませんでした。
9月4日の検証:普段の指示を含めると消費量が変わった
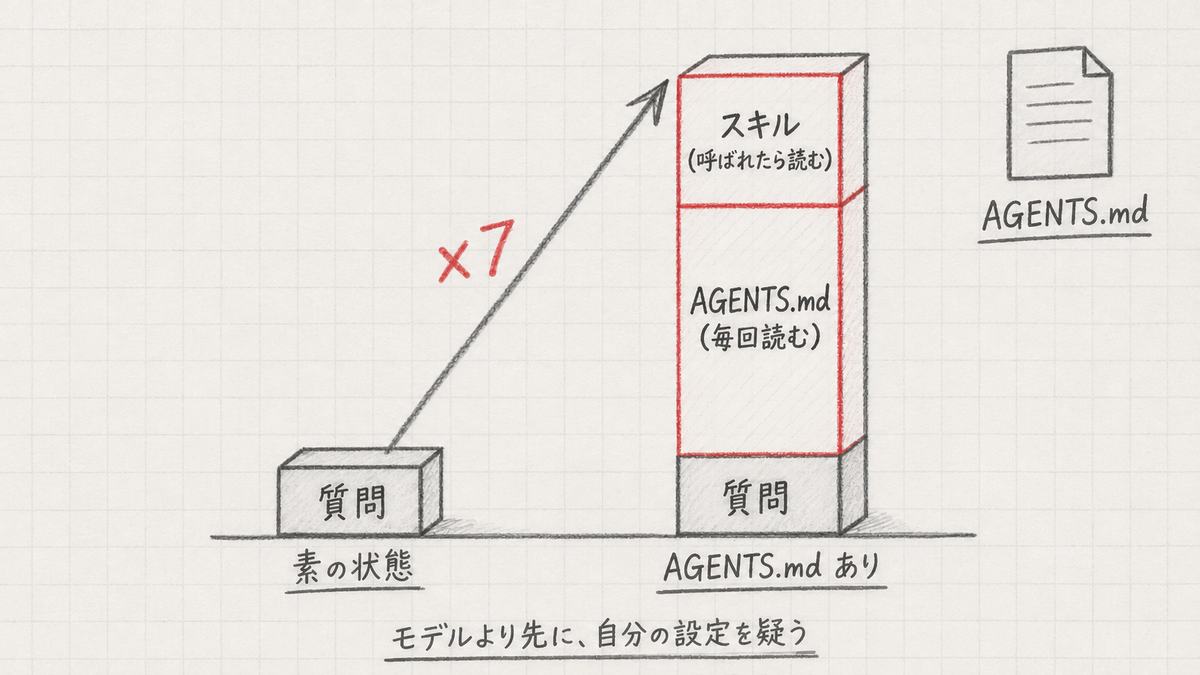
測っていて一番驚いたのはここです。同じ雑談を、ふだん自分が使っているAGENTS.md(Codexが毎回最初に読む設定ファイル)を置いた状態で頼むと、0.5クレジットが3.5クレジットになりました。調べものは1.6が9.3。6〜7倍です。
当時の記録では、指示に従った追加のファイル読取りも発生していました。指示文の長さだけでなく、呼ばれた道具や追加のやり取りも含む比較です。「AGENTS.mdを短くすれば必ず7分の1になる」という結果ではありません。
初稿では雑談の1回について、考える深さをhighにしてもトークン数が変わらなかったと記録しています。これもその依頼だけの観測であり、深さの設定が消費に影響しないという意味ではありません。
消費を減らすには、依頼の範囲と速度設定を見直す
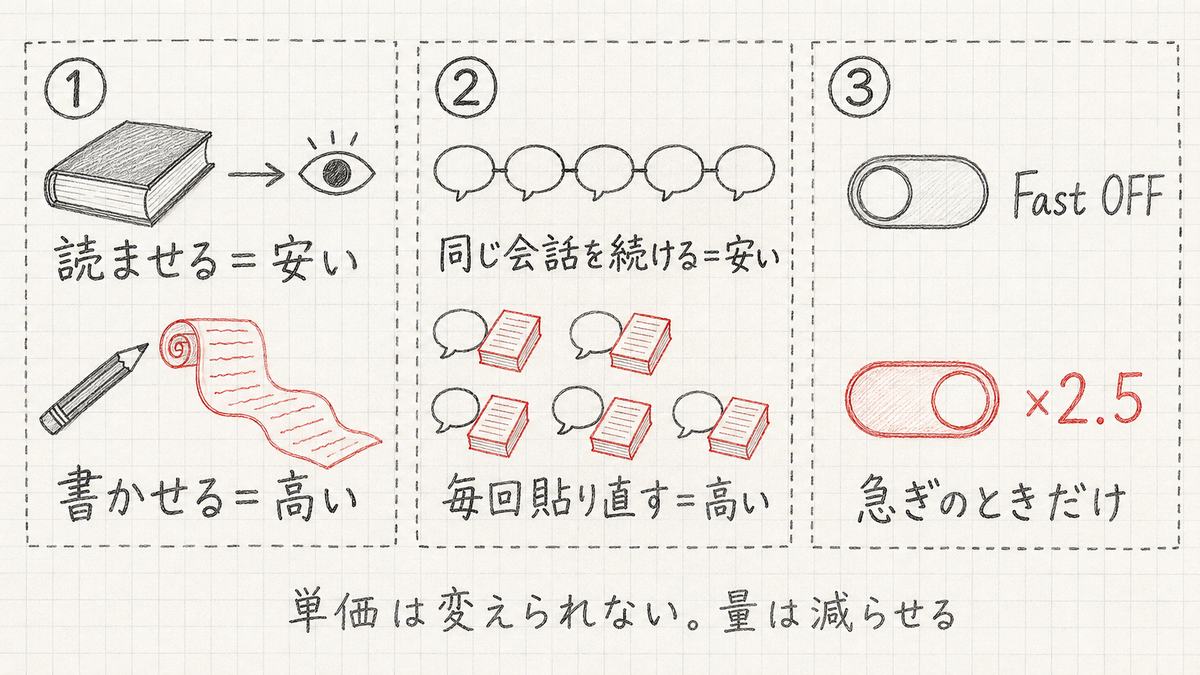
- •必要な成果物と長さを指定する。出力単価は通常入力の5倍ですが、総額は読み込む量や内部で考える量にも左右されます
- •関係する資料だけを渡す。キャッシュが効いた入力は安くなりますが、長い会話を続ければ常に得とは限りません
- •Fast modeは急ぎのときだけ。付けっぱなしだと2.5倍の速さで減ります
AGENTS.mdは、不要な重複や毎回関係ない指示を減らします。ただし、削除前の確認や秘密の扱いなど、必要な規則まで消すのは逆効果です。今回の検証でも、短い質問の裏でCodexの基本指示やスキル一覧が入力に含まれていました。
今回測れていないこと
初稿で使った7本のプロンプトと入力データを、この端末では回収できていません。そのため今回は、新しく用意した4課題での追加比較です。前回7本の完全再現、ブラウザ操作やExcel作成でのAstraとの比較、Plusや別のPro枠での実消費は未検証です。元の実験条件がそろった段階で、同じ7本の再測定を行う必要があります。
よくある質問
GPT-6 Astraはいつから使える?
筆者の環境では2026年9月6日にCodex CLIでAstraの応答を確認しました。すべてのアカウントへの提供完了を確認したものではありません。自分の環境ではモデル選択画面で確認してください。
Codexでgpt-6-astraを選べないのはなぜ?
提供状況だけでなく、ログイン中のアカウントや使っている入口を確認してください。筆者は9月4日には未対応でしたが、9月6日にはCLIから利用できました。対話画面では /model、起動時には codex --model gpt-6-astra で選択できます。エラーが出る場合は、その文面を根拠に原因を調べます。「必ず順番待ち」とは断定できません。
Plusで使える? 何回まで?
公式目安はPlusで5時間あたり5〜45回です。実際に使える回数は作業や設定で変わり、週の上限が適用される場合もあります。残量は自分の利用状況画面を確認してください。
GPT-5.6 Solとの違いは?
標準単価はAstraが2.5倍です。一方、1作業で使うトークン数はモデルの進め方で変わります。今回の4課題は短い依頼であり、開発全体や画面操作の能力差を判定するものではありません。
「GPT-6 Astra Pro」とは?
通常のAstraより計算に時間をかけるpro modeと、月額契約のChatGPT Proは別の概念です。今回測ったのは通常の gpt-6-astra のmedium設定であり、pro modeの費用や性能は測っていません。
ChatGPTの普通のチャット画面も同じ枠?
違います。この記事のクレジットの話は「Work」と「Codex」の枠です。普通のChat画面は別の回数制限で動きます。
参照元
更新履歴:2026年9月6日、Astraを含む4課題・各3回の追加検証を掲載。公式の利用回数目安とFast modeの説明を更新。「頭の良さは同じ」「消費は必ず2.5倍」という断定を訂正し、9月4日の換算値と今回の実測を区別しました。

Backend Engineer / AWS / Django / Go